Text to speech italiano realistico: a quali strumenti affidarsi
 2 Settembre 2026
 13 minuti
 3.584 visualizzazioni

Oggi chi cerca uno strumento di text to speech italiano realistico ha a disposizione numerose soluzioni in grado di trasformare qualsiasi testo scritto in audio, con una voce naturale ed espressiva.
Se un tempo bisognava usare software complessi o accontentarsi di voci robotiche dal classico suono metallico, ormai i progressi dell’intelligenza artificiale hanno migliorato notevolmente esperienza utente, rapidità del lavoro e la qualità della sintesi vocale. Adesso i migliori strumenti di text to speech italiano con AI permettono non solo di scegliere tra voci diverse, ma in molti casi anche di intervenire su aspetti come ritmo, velocità di lettura, emozioni, intonazione, pause ed enfasi.
Le possibilità di utilizzo sono davvero molte: la sintesi vocale viene usata per realizzare voice-over per video, lezioni online e presentazioni, audiolibri, podcast e contenuti per i social media, oppure per aggiungere una narrazione ai corsi e-learning senza dover registrare ogni volta l’audio. Inoltre, la capacità di questa tecnologia di lavorare in qualsiasi lingua la rende perfetta per la localizzazione di articoli, audioguide, narrazioni, prodotti, audio e video YouTube per audience di tutto il mondo.
Ma tra tutte le soluzioni text to speech italiano online, quale conviene scegliere? In questa guida vedremo come funziona il text to speech, quali caratteristiche è utile confrontare e quali sono, secondo noi, le migliori soluzioni disponibili per creare contenuti audio e voci in italiano con la sintesi vocale e strumenti IA.
Crea text to speech italiano in pochi clic con lo strumento conforme al GDPR!

TTS online per l’italiano
Qui trovi solo una breve panoramica degli strumenti che abbiamo scelto di prendere in esame dopo una ricerca online:
- iSpring Suite AI: uno strumento per la creazione di corsi e-learning che include funzionalità di sintesi vocale e permette di generare voice-over direttamente mentre si lavora sui contenuti del corso. La nuova integrazione con ElevenLabs mette a disposizione voci IA particolarmente realistiche ed espressive.
- Google Cloud Text-to-Speech: il servizio TTS di Google dedicato soprattutto a sviluppatori e organizzazioni che vogliono integrare la sintesi vocale nelle proprie applicazioni e nei propri servizi.
- Narakeet: una web app con sintetizzatore che consente di trasformare testi e documenti in contenuti audio e offre un’ampia scelta di voci e lingue, comprese numerose voci italiane maschili e femminili.
- SpeechGen: un generatore vocale online che permette di creare file audio a partire da un testo e intervenire su parametri come velocità, intonazione, pause ed enfasi.
- CapCut: conosciuto soprattutto come editor per la creazione di video e contenuti per i social media, include anche una funzione text to speech che permette di generare una voce a partire dal testo direttamente durante l’editing.
- Voicertool: uno strumento online più semplice, pensato per chi vuole convertire rapidamente un testo in voce e scaricare il risultato come file audio.
Più avanti esamineremo queste soluzioni una ad una per trovare il sintetizzatore vocale italiano migliore in base alle tue necessità, analizzeremo più da vicino questi strumenti di TTS e confronteremo caratteristiche, qualità delle voci e possibilità di utilizzo. Prima di confrontare i diversi strumenti disponibili e di aiutarti a trovare il miglior text to speech italiano per i tuoi progetti, però, vale la pena chiarire cosa si intende per text to speech.

Cos’è la sintesi vocale
Il TTS (Text-to-Speech), o sintesi vocale, converte un testo scritto in un contenuto audio: il software analizza le parole inserite e genera una voce artificiale che le legge ad alta voce. Questa trasformazione da testo a voce viene eseguita da un cosiddetto sintetizzatore vocale che riesce a convertire il testo e riprodurre il suono della lingua parlata dagli utenti. La traccia audio generata dal sintetizzatore può essere scaricata in formato mp3, pubblicata online, ecc.
Come molte altre tecnologie, anche il text to speech ha fatto passi da gigante negli ultimi anni, soprattutto grazie al magico tocco della tanto acclamata intelligenza artificiale.
Con i sistemi tradizionali di conversione testo in voce, il risultato era spesso facilmente riconoscibile per il tono piatto e poco naturale della traccia audio finale. Oggi, invece, qualsiasi sintetizzatore vocale avanzato riesce a riprodurre con maggiore precisione la voce umana e il modo in cui parliamo, gestendo elementi come pronuncia, velocità, emozioni, ritmo, intonazione, ecc.
Stiamo parlando di una tecnologia potente e, allo stesso tempo, molto semplice da usare. Per usare un qualsiasi TTS online in italiano basta inserire o incollare il testo nell’apposito editor (di solito con un clic su “input text”), selezionare la lingua (o le lingue) di cui si ha bisogno e una delle voci TTS disponibili per fare entrare in funzione il sintetizzatore.
Molti servizi di sintesi vocale permettono di scegliere tra voci maschili e femminili realistiche, modificare alcuni parametri della lettura e scaricare il risultato in formato mp3 o in altri formati audio. La qualità del risultato varia a seconda della lingua, dalla piattaforma o applicazione scelta e da molti altri aspetti.
Come già accennato, i servizi TTS audio possono essere utilizzati per esigenze molto diverse, dalla creazione di un semplice campione audio alla produzione di voice-over, podcast, audiolibri e contenuti e-learning. In contesto aziendale, molte organizzazioni usano queste tecnologie per aggiungere voice over ai propri corsi di onboarding o formazione, presentare l’azienda con un discorso, e molto altro.
TTS italiano con AI
L’intelligenza artificiale ha migliorato notevolmente la qualità della sintesi vocale e oggi sono disponibili numerosi strumenti di text to speech in italiano di altissimo livello. La scelta dipende soprattutto dall’uso che vuoi farne, dalla qualità che ti serve e dalle funzionalità di cui hai bisogno. Vediamo quali sono, secondo noi, le soluzioni più interessanti.
iSpring Suite AI
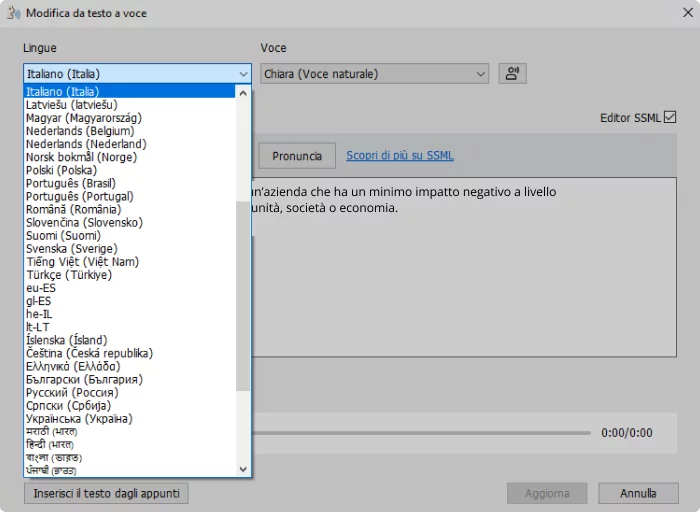
iSpring Suite AI è una soluzione pensata principalmente per chi crea corsi e-learning, presentazioni e altri contenuti didattici. A differenza dei servizi dedicati esclusivamente alla sintesi vocale, iSpring ha un sintetizzatore da testo a voce integrato che genera dialoghi e narrazioni direttamente mentre si lavora al corso: basta inserire il testo, scegliere la voce desiderata e aggiungere l’audio alle slide senza ricorrere a programmi esterni.
La funzione text to speech di iSpring Suite supporta 53 lingue, mette a disposizione 378 voci e permette di intervenire anche sul modo in cui viene letto il testo: con l’editor SSML puoi modificare la velocità e l’intonazione, inserire pause e stabilire come devono essere pronunciati singoli caratteri, sigle o determinate parole in ciascuna lingua.
Questo strumento ti dà accesso anche alle voci IA di ElevenLabs: uno dei software di sintesi vocale più avanzati disponibili. Il loro punto di forza è soprattutto la naturalezza: intonazione, ritmo ed espressività si avvicinano maggiormente al modo di parlare di una persona e rendono la narrazione meno monotona e più piacevole da ascoltare, ideale anche per i creatori di video e lezioni su YouTube o altri social media.
Le voci di ElevenLabs permettono di ottenere voice-over di qualità professionale senza organizzare registrazioni o utilizzo altri software esterni. Se il contenuto di una lezione cambia, è possibile modificare il testo e il sintetizzatore vocale si occuperà di convertire il testo in voce automaticamente.
E iSpring Suite AI non si limita al generatore text to speech: ti aiuta a creare corsi, quiz, simulazioni di dialoghi, video e molto altro senza dover passare continuamente da uno strumento all’altro. Anche per questo, iSpring Suite è già utilizzato per la formazione da grandi organizzazioni internazionali come L’Oréal.
Basta un clic per iniziare il download della versione di prova gratuita, oppure per richiedere una demo senza impegno e scoprire tutte le funzionalità dello strumento.
Google Cloud Text-to-Speech
Un sacco di gente usa almeno la mail, ma non tutti conoscono Text-to-Speech: il servizio di sintesi vocale di Google, pensato soprattutto per sviluppatori e organizzazioni che vogliono integrare la conversione automatica di testo in voce in applicazioni, siti o servizi digitali. L’API offre più di 380 voci in oltre 75 lingue e varianti, tra cui numerose voci in italiano.
Tra le soluzioni disponibili troviamo le voci Chirp 3 HD e Gemini-TTS, che consente di controllare attraverso semplici prompt aspetti come stile, accento e modalità di lettura. A seconda del modello utilizzato, Google supporta anche testo semplice e SSML e permette di intervenire su emozioni, pronuncia e altri parametri della sintesi vocale per aumentare il livello di qualità del risultato.
L’audio può essere generato in file MP3, OGG Opus, Linear16 e altri formati, mentre per alcuni modelli è possibile creare anche una voce personalizzata partendo da un campione audio.
Narakeet
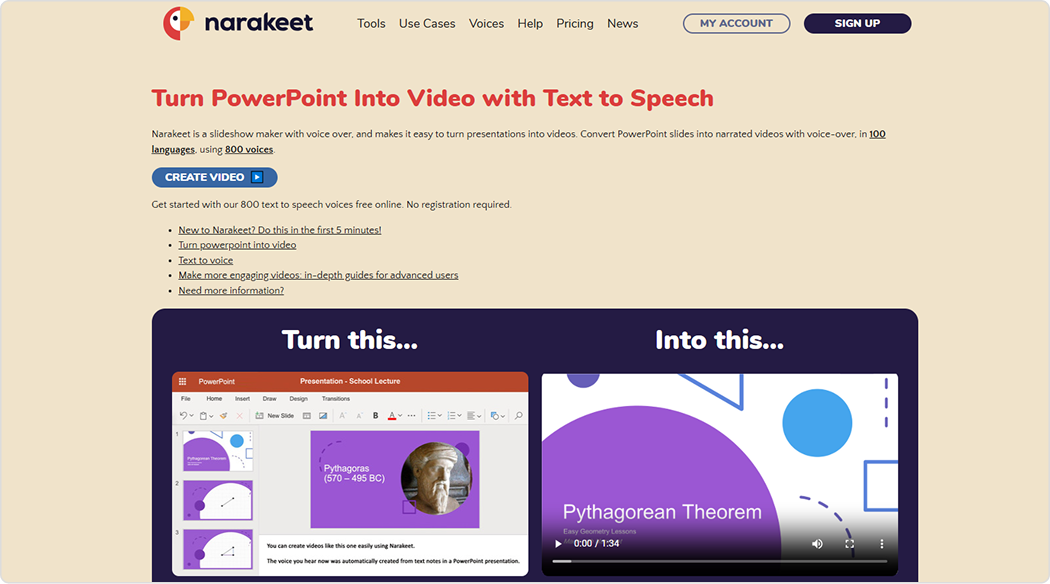
Narakeet è una piattaforma online per la sintesi vocale nata prima di qualsiasi IA. Questo strumento dà agli utenti accesso alla possibilità di convertire da testo a voce direttamente dal browser, senza installare alcun software.
Il servizio offre 123 voci in lingua italiana, sia maschili che femminili, e può essere utilizzato per realizzare voice-over, audiolibri, lezioni, presentazioni e contenuti e-learning. Ovviamente, sono presenti anche tantissime altre lingue per il text to speech.
Usarlo è molto semplice, soprattutto le funzionalità base: puoi scrivere o incollare il testo nell’editor oppure caricare direttamente alcuni tipi di file, come documenti Word e sottotitoli. Dopo aver scelto la lingua (Italy, IT) e la voce, puoi regolare parametri come velocità e volume e selezionare il formato del file audio. Il sintetizzatore vocale Narakeet permette di scaricare il risultato in mp3 o WAV con l’opzione text to mp3 italiano (e altre lingue).
Complessivamente sono disponibili oltre 900 voci in 100 lingue, una caratteristica interessante per chi deve produrre gli stessi audio per Paesi diversi. Inoltre, è possibile provare questo sintetizzatore vocale gratuitamente per 20 file audio senza registrazione.
Secondo noi, Narakeet è una soluzione interessante soprattutto per chi cerca uno strumento online immediato per trasformare testi e documenti in file audio, senza avere bisogno delle funzionalità più avanzate. Forse il miglior TTS italiano per chi usa il text to speech saltuariamente, oppure ha bisogno di creare pochi file voce di qualità accettabile, magari per un lavoro in contesto educativo o scolastico, brevi video, una ricerca e simili.
SpeechGen
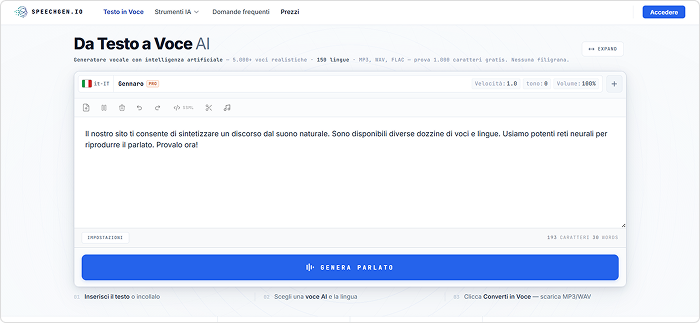
SpeechGen è un altro sintetizzatore vocale text to speech in italiano con download di buona qualità. Offre oltre 120 voci AI in italiano, sia maschili che femminili. Il servizio funziona direttamente dal browser: puoi inserire il testo, scegliere le lingue, ascoltare un’anteprima della voce e generare l’audio senza installare altri programmi.
Rispetto a soluzioni più essenziali, il sintetizzatore vocale SpeechGen offre diverse possibilità di personalizzazione: controllare le pause tra frasi e paragrafi e utilizzare i tag SSML per intervenire più precisamente sulla lettura. È anche possibile assegnare voci diverse a parti dello stesso testo, una funzione utile, ad esempio, per il lavoro su dialoghi o contenuti formativi con più speaker.
Una volta generata la voce con questo strumento text to speech, puoi scaricarla in mp3, WAV, FLAC, OGG e OPUS. Anche SpeechGen offre una prova gratuita per i primi 1.000 caratteri, senza registrazione, così da creare un breve campione audio e valutare la voce prima di acquistare altri crediti.
Tra le funzionalità più recenti trovi anche la clonazione vocale con IA: partendo da un breve campione di voce registrato, è possibile creare un modello della propria voce e utilizzarlo successivamente per generare nuovi contenuti audio o video in varie lingue.
Secondo noi, SpeechGen è particolarmente adatto a chi cerca un convertitore da testo a voce con molte possibilità di personalizzazione e vuole avere un controllo piuttosto preciso sul file audio finale.
CapCut
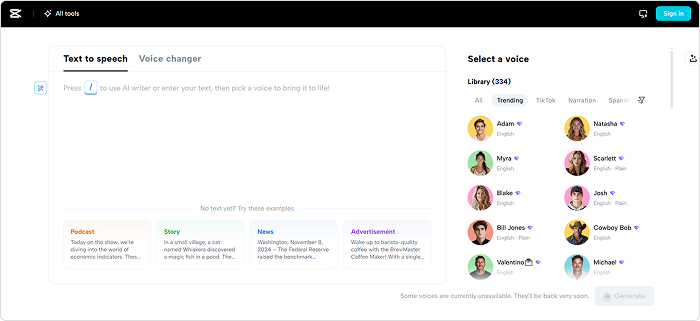
CapCut è conosciuto soprattutto come editor video, ma include anche uno strumento di sintesi vocale text to speech con cui trasformare qualsiasi testo in un voice-over e inserirlo direttamente nel progetto. È disponibile online, su desktop e su dispositivi mobili, quindi può essere una soluzione pratica soprattutto per chi crea video per social media, tutorial, presentazioni o altri contenuti audiovisivi.
Il generatore mette a disposizione oltre 200 voci IA in diverse lingue e consente di scegliere lo stile più adatto al contenuto. Dopo aver inserito il testo e selezionato la voce, puoi ascoltare un’anteprima e generare la traccia da inserire direttamente nel video oppure scaricare come file audio. Tra i formati disponibili troviamo mp3, WAV, FLAC e AAC.
Il vantaggio principale, secondo noi, rimane l’integrazione del convertitore di testo in voce con gli strumenti di video editing: puoi generare il voice-over, sincronizzarlo con video, immagini e sottotitoli e continuare a lavorare sul progetto senza passare da un’applicazione all’altra.
Voicertool
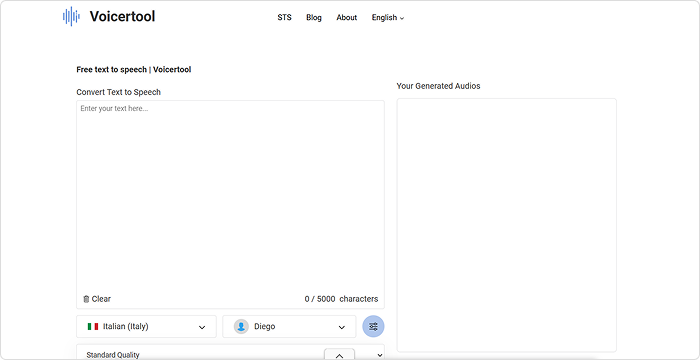
Voicertool è un servizio di sintesi vocale online gratuito, pensato per chi vuole trasformare rapidamente un testo in voce senza installare software o creare un account. Attualmente offre oltre 300 voci IA in più di 70 lingue, tra cui l’italiano, e consente di inserire fino a 5.000 caratteri per volta.
Usarlo è davvero semplice: basta incollare il testo nell’editor, scegliere la lingua e la voce e avviare la generazione. Uno degli aspetti più interessanti è l’assenza di limiti giornalieri al numero di conversioni. e di watermark. I file voce generati possono essere usati in presentazioni e video anche a scopo commerciale.
Secondo noi, Voicertool è una soluzione adatta soprattutto a chi cerca un TTS gratuito e molto semplice e usa la voce sintetica per brevi video o contenuti online, senza avere bisogno di funzioni più avanzate.
Conclusioni
Gli strumenti di sintesi vocale disponibili oggi permettono di ottenere risultati molto più naturali rispetto al passato, ma non esiste una soluzione migliore in assoluto. La scelta dipende dal tipo di contenuto che vuoi creare: un servizio online essenziale può essere sufficiente per generare occasionalmente un file audio, mentre video, audiolibri e corsi e-learning possono richiedere funzioni più avanzate e un maggiore controllo sulla voce creata.
Per chi lavora nell’e-learning e usa software per la formazione, è importante poter generare la voce fuori campo direttamente mentre si sviluppa il corso. iSpring Suite AI riunisce la sintesi vocale e gli strumenti per creare quiz, video e altri contenuti interattivi, evitando di dover utilizzare diversi programmi per completare lo stesso progetto.
Se vuoi valutare personalmente questo strumento text to speech italiano realistico, puoi provare gratuitamente iSpring Suite AI per 14 giorni o richiedere una demo per scoprire come funziona.
FAQ
Come funziona speech to text?
Lo speech to text (STT) esegue il processo inverso rispetto al text to speech: parte dalla voce e la trasforma in testo scritto. Il software usa gli algoritmi per analizzare un contenuto audio o il parlato in tempo reale, riconosce le parole pronunciate e le trascrive automaticamente.